



四千万条学习行为数据
能预测你的期末成绩吗?
兰大高等教育研究院副教授罗杨洋做到了
他把学生在线行为分成五类画像
用算法提前“剧透”成绩
这份研究获得
第十届教育部科学研究优秀成果奖
(人文社会科学)
奖项已成为过去
他仍在追问
如何让算法更懂教育?
让我们走进
他的混合课程学习成绩预测研究
看看他的过去和未来
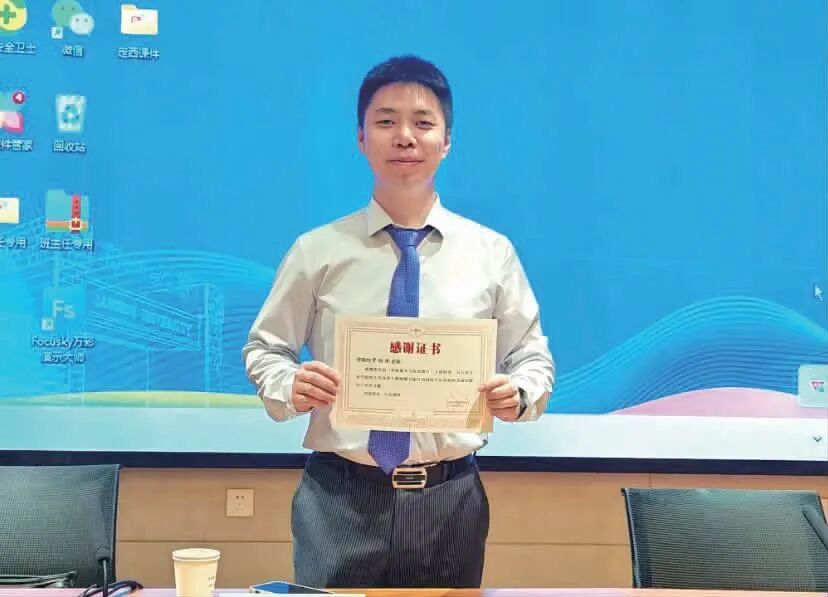
拿到第十届教育部科学研究优秀成果奖(人文社会科学)青年成果奖时,罗杨洋又惊又喜。然而比起奖状,他更愿意谈的是一连串追问:混合课程的成绩,凭什么靠学生线上学习行为来预测?能预测多大比例?换一门课、换一所学校,模型还能不能用?算法精度和教育可用性冲突时,又该往哪头取舍?
这位从计算机学科转到教育领域的兰州大学高等教育研究院副教授,获奖成果是专著《基于学生在线行为的混合课程学习成绩预测研究》。这些年,罗杨洋一直在做一件事:把自己做的学生成绩预测研究,翻译成一线老师听得懂的大白话。
一个“凭什么”的起点
“我是计算机学科转到教育的。”罗杨洋说,导师也建议他做教育大数据和学习分析。他后来才明白,软件工程和教育技术学不是一回事。“教育技术是教老师怎么去教学生的。教育大数据和学习分析只是教育评价研究的一个子领域,我做的是后者。”而他做的,是把计算机那套数据分析的方法,搬进教育研究里。
他最初做这个题目,是想通过分析学生在线学习行为,部分预测混合课程学生的学习成绩。但在学习分析领域,以往不少研究是“把数据拿来就预测”。罗杨洋对此感到迷惑:为什么仅凭学生的线上学习数据就能把混合课程的所有成绩都预测了?
他把研究渊源追溯到上世纪70年代美国对高中生三年成绩预测大学第一年成绩的研究,当时线性回归模型准确率已接近50%;后来美国高校用这类研究做学业预警,教育大数据研究则收集登录、上线看课等在线活动,预测学生是否会不及格。2018年他到清华读书时,研究所正在推混合课程,国内外已有人把相关技术应用到混合课程中。这些背景构成了书名三个关键词的研究主线:以学生在线行为为起点,以混合课程为对象,以学习成绩预测为目标,但首先要追问“凭什么能预测”。
他把自己的做法和日常教学中的预测做了区分。“中小学老师一直都在做预测——周考、月考、一模、二模,不就是为了预测学习成果吗?只不过他们用的是终结性考试成绩,而我想做的,是把过程性的学习行为数据也加进来。”
数据来自学生们在线学习课程的后台日志数据。“我不是从访谈、课堂观察出发,而是用数据说话。”他说,这样做的目的,是在研究前先给课程归类,判断预测的条件。他管这叫“条件性预测”:“普适性预测就是这样,条件性预测就是你得讲控制变量。”
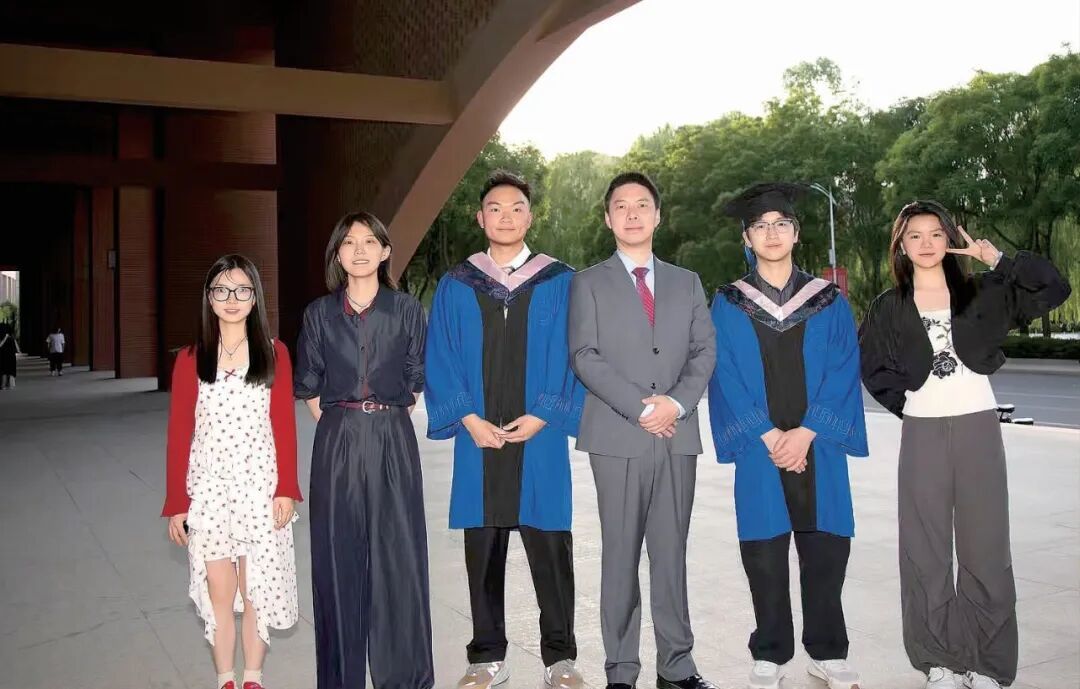
罗杨洋和他的学生
四千门课里找“药理”
为了做研究,团队把某高校混合课程的网络教学平台日志导出来,按教师建课的活动类型和频次做聚类。老师们在平台上布置作业、发起讨论、点名签到,每一种操作后面都匹配着学生的学号记录。用活动类型、频次、人数和时间戳特征,把混合课程聚成五类。
“比如说有教师喜欢布置作业、喜欢课堂抽查、喜欢点名,这个就可以归为作业这一类。如果教师喜欢辩论,我们会在设置讨论的小板块。”
那么,这一大堆数据跑出来,到底告诉了我们什么?
聚类结果出来后,只有“高活跃型”混合课程,用在线行为预测成绩才能获得可接受的准确率。罗杨洋和合作者收集了某高校两学期全部混合课程的数据,用随机森林算法分别以批量学习和增量学习两种方式建模。研究成果发表在《电化教育研究》2021年第7期:增量学习随机森林在样本最多的合并数据集中取得了最高预测准确率75.1%。更重要的是稳定性的变化——样本数量达到一定规模后,预测结果的准确率波动明显减小。
团队还研究了模型的可迁移性。用A校四千多门混合课程数据构建模型,再把它迁移到B校一门连续三学年的混合课程上。结果发现,当目标课程的学生在线行为数据分布和“高活跃型”相似时,2018学年预测准确率达到69.4%,2019学年达到72.4%,而2017学年三种迁移方式都在34%左右。
在可解释性研究中,他用五种算法构建模型并逐一拆解推理机制。随机森林模型最高能预测正确74.7%的学生,但成绩为A和B的学生预测准确率高达80%以上,成绩为C及以下的学生最高只有63%。论文提醒一个容易被忽略的可信度条件:当学生个体在某项或某几项在线学习行为上没有数据时,模型对该学生的预测可信度较低。换句话说,数据缺失的学生,恰恰可能是最需要老师留意的学生。
研究过程中,罗杨洋注意到课堂里的参与度偏低的学生。在讨论型课堂里,不管课堂整体多活跃,总有那么两三个边缘学生。“到底是什么原因导致他边缘的?”数据能告诉教师“有这样的人存在”。
准确率还随算法、样本不同而变化,样本往往只有四五百人。“这种片面数据去预测,肯定有问题,但问题出在哪儿,暂时找不到。”于是,他决定把研究做下去,“至少研究失败了,也能告诉别人哪些课程能做、哪些不能做”。
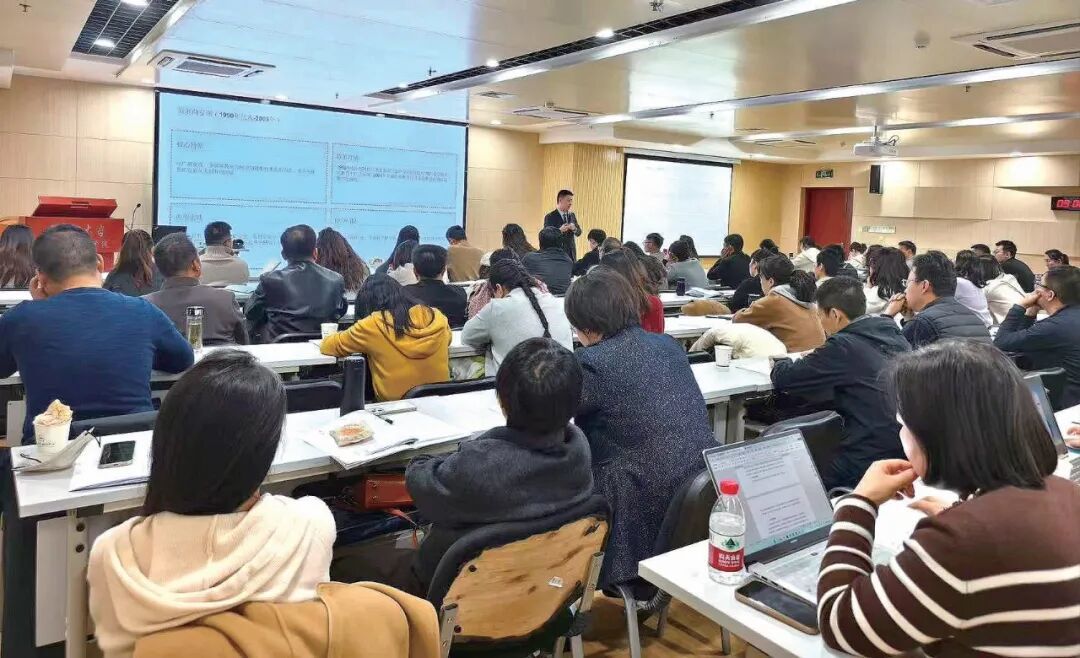
罗杨洋在给老师们培训
把论文翻译成大白话
2021年,罗杨洋到兰州大学高等教育研究院工作。随着他的研究不断深入,他参与到“国培”项目的培训方式也慢慢在发生变化。“刚开始讲‘30个微能力点’时,照本宣科讲,老师们听得云里雾里。后来我把课堂改成上半节课讲思路,下半节课挑一个老师们感兴趣的智能体,现场做教案、做微课视频,遇到问题当场解决。”罗杨洋坦言。
罗杨洋用一个词形容这套做法:“教学过程工程化。”自2021年起,他深入平凉、张掖、嘉峪关、庆阳等地中小学宣讲,参与“国培计划”各级培训三十余场。
这些工作陆续获得了一些认可。成果发表于《中国电化教育》《电化教育研究》《中国远程教育》《清华大学教育研究》及AsiaPacificEducationRe-view等期刊,获批甘肃省高等教育教学改革重点项目,获甘肃省哲学社会科学奖二等奖。2026年,他作为第二完成人的成果获得河南省本科高等教育教学成果二等奖。
谈到人工智能带来的伦理风险,罗杨洋表示,自己担心“思考外包”“认知卸载”,但最大的风险是“人类再没有创新”。AI把人类顶尖成果训练之后,可能达到第二、第三高峰;学生还在登山,忽然给他一座高峰,他就会觉得用这个成果就可以了。他强调,知识是形成价值判断的基础,体验不能替代。
对于在西部做研究,罗杨洋认为文科研究可以转型,从传统研究方法转到交叉学科方法,从具体的人做到大数据再回归具体的人,从课程学习分析做到学校数据治理和数字化规划。“我们西部还是有我们西部的坚守,西部的同学还是来自于五湖四海,他们也有他们的期待。只要把自己的教育教学工作做好,研究自然就有特色了。”
周末组会上,他会问学生同一个问题:你这个概念界定的依据是什么?这几个概念之间有没有交叉?交叉了,说明你界定错了。
从博士论文答辩时被专家问“和教育有什么关系”,到在国培讲台上把论文拆成大白话,再到周末组会上追问学生“依据是什么”——罗杨洋最初的研究困惑,就是“凭什么”。
这份研究
不止停留在论文里
它已通过国培计划落地
走进教师的课堂
助力数字素养提升
文字丨邓思晗
(兰州大学官方公众号)



